




Elige un idioma
Un cantante de pop, un proyecto para llevar delfines al lago Balatón y un sitio de noticias húngaro desconocido para la mayoría de europeos: a primera vista, se podría decir que el caso Like Company contra Google Irlanda está más relacionado con la prensa rosa que con un pleito histórico para el futuro digital del periodismo europeo. Sin embargo, este insólito caso, ahora ante el Tribunal de Justicia de la Unión Europea (TJUE), podría determinar en qué grado las empresas de “Big Tech” pueden usar contenido periodístico para crear y ejecutar sistemas de inteligencia artificial (AI) sin pedir permiso o pagar por ello.
Según el diario húngaro HVG, el litigio comenzó con un artículo publicado en julio de 2023 por Balatonkörnyéke, un portal local de noticias húngaro. La noticia contaba que el conocido cantante y compositor húngaro Koszó no había abandonado la idea de introducir delfines en el lago Balatón.
Poco después, un usuario pidió a Gemini, el chatbot de Google, un resumen del artículo. El chatbot generó una respuesta de varios párrafos en la que describía el supuesto proyecto, sus posibles repercusiones turísticas, así como su naturaleza controvertida. Sin embargo, según el tribunal regional de Budapest, que juzgó el caso en primera instancia, también incluyó datos que no aparecían en el artículo original. El tribunal remitió el caso al TJUE el 3 de abril de 2025.
Esta historia excéntrica no es lo único que está en juego. El 10 de marzo de 2026, en la Gran Sala del TJUE tuvo lugar lo que los observadores jurídicos describieron como la primera vista oral en torno a la IA y la legislación de la UE sobre derechos de autor, centrada en la pregunta por la que los dueños de los medios de comunicación, los artistas y las empresas de IA llevan años luchando: cuando un sistema de IA se entrena con contenido protegido y este luego produce una respuesta basada en ese contenido, ¿aplica la ley sobre derechos de autor?
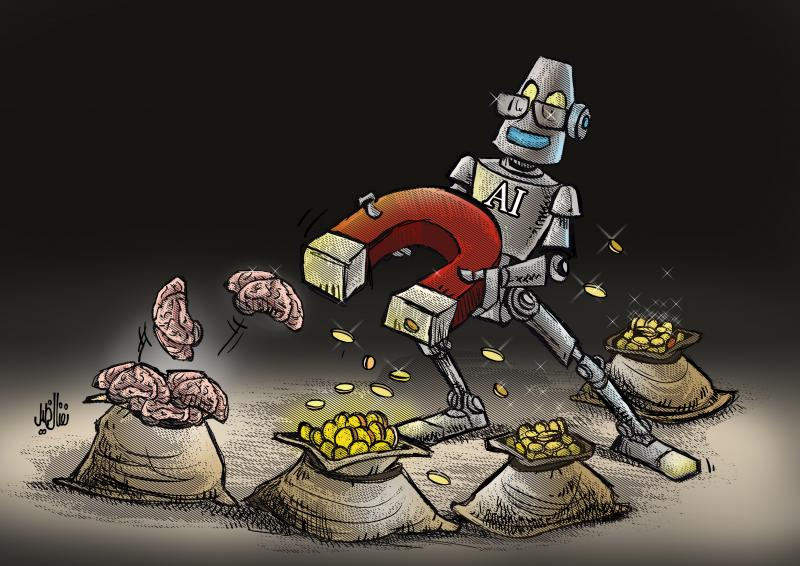
Los grandes modelos de lenguaje (LLM) se entrenan con conjuntos de datos ingentes que incluyen libros, artículos, sitios web y otros escritos. Las empresas de IA opinan que esta etapa es esencial para crear herramientas de IA útiles y que el proceso constituye una de las excepciones jurídicas contempladas para fomentar la investigación y la innovación.
Los argumentos de Google y del sector mediático
El principal argumento de Google es que su modelo de IA no almacena artículos de la misma forma que una base de datos almacena documentos, sino que aprende los patrones estadísticos: divide el texto en fragmentos, identifica las relaciones y las codifica en el sistema. Desde esta perspectiva, la empresa sostiene que al generar una respuesta el sistema no “copia”, predice texto.
Los dueños de los medios de comunicación y los periodistas no lo ven así: las herramientas de IA procesan artículos para construir productos que responden directamente a las preguntas de los lectores. Por lo tanto, reducen la necesidad de que el usuario visite la fuente original. Antes, el buscador de Google dirigía el tráfico a las fuentes, si bien de manera desigual. En las formas de búsqueda actualmente en desarrollo, las plataformas aspiran a que los usuarios permanezcan en su propia interfaz, y en consecuencia, impedir generar tráfico web hacia los sitios de los que obtienen la información en cuestión.
La cuestión económica que deriva de este sistema surge de manera natural: ¿qué valor tiene el trabajo del periodista si los lectores reciben una respuesta lista para consumir en lugar de un link? Los dueños de los medios de comunicación, los periodistas y los autores también argumentan que están utilizando su trabajo sin permiso ni compensación, especialmente en casos en los que los sistemas generan respuestas muy similares al contenido original o que compiten con él.
La legislación europea ya incluye instrumentos relevantes para este litigio, aunque ninguno se escribió con los chatbots actuales en mente. Una directiva de 2001 otorga el control de la reproducción y comunicación de su obra a los propietarios de los derechos. Una directiva de 2019 introdujo excepciones para permitir la extracción de texto y datos (es decir, el procesado automático de grandes cantidades de contenido), incluyendo materiales de libre acceso, excepto si los propietarios de los derechos deciden retirarse de manera voluntaria. Sin embargo, los límites de estas excepciones, especialmente en el ámbito de la IA comercial, aún no se han sometido a prueba jurídica.
Tres posibles resultados
El caso de Like Company podría forzar al tribunal a aclarar dónde están los límites. Si los jueces deciden que el entrenamiento de la IA se considera una reproducción a tenor de la legislación de la UE sobre derechos de autor, es posible que los desarrolladores necesiten una licencia, tendrán que respetar a quienes retiren su consentimiento o apoyarse en excepciones concretas. Si dictaminan que el entrenamiento de estos sistemas está totalmente al margen de los derechos de autor, podría desvanecerse uno de los argumentos jurídicos más sólidos expresados por los propietarios de los medios de comunicación.
Una tercera vía (centrada en lo que produce la IA) requeriría que el tribunal decidiese en qué circunstancias la respuesta de un chatbot se parece lo suficiente a un artículo protegido como para considerarse una violación de los derechos de autor. El Servicio de Estudios del Parlamento Europeo apunta que el entrenamiento de la IA está basado en grandes conjuntos de datos que podrían incluir material protegido por derechos de autor y que la UE ha creado tanto derechos como excepciones relevantes para este proceso.
Según Paul Nemitz experto en digitalización y profesor invitado en el College of Europe, los medios independientes se juegan muchísimo con este caso. “Si el tribunal acepta los argumentos de Google, aunque sea parcialmente, los medios de comunicación privados europeos están condenados a desaparecer”, advierte. “Solo sobrevivirán los medios públicos y se habrá acabado con el poder innovador de la cultura y la crítica en favor de la democracia, cuyo principio fundamental es que debe haber un camino abierto al cambio”.
“Si el tribunal acepta los argumentos de Google, aunque sea parcialmente, los medios de comunicación privados europeos están condenados a desaparecer” – Paul Nemitz
La legislación europea, según Nemitz, ya ofrece el marco adecuado: “Por un lado, [existen] unas protecciones sólidas de los derechos de autor en el caso de obras que son lo suficientemente nuevas como para considerarse una expresión de la genialidad humana. Por otro lado, [está] la excepción del contenido protegido para extraer texto y datos”.
Esta excepción se diseñó para permitir el progreso científico, no para permitir la extracción a gran escala de contenido periodístico y cultural por parte de sistemas de IA comerciales. E insiste en que cualquier interpretación debe darse teniendo en cuenta el marco de derechos fundamentales de la UE y la función democrática del periodismo independiente.
La European Copyright Society, entre cuyos miembros se encuentran académicos líderes en el tema de los derechos de autor, ha expresado sus reservas. En su opinión, los chatbots, los modelos de IA y los motores de búsqueda implican distintas operaciones técnicas y jurídicas y no deberían considerarse como una única categoría. También advierte contra una resolución demasiado amplia que dé lugar a un mercado de concesión de licencias solo útil para los mayores proveedores de IA. Además, reconoce que usar contenido protegido sin permiso suscita grandes preocupaciones.
El momento justo
El litigio llega en el momento justo. La UE ya está implementando su Ley de Inteligencia Artificial, que obliga a los proveedores de grandes modelos de IA a adoptar políticas de cumplimiento de derechos de autor, respetar el derecho de los propietarios a oponerse, así como publicar resúmenes del contenido que utilizan para el entrenamiento. Pero la ley no resuelve la cuestión subyacente de los derechos de autor, pues insta a las empresas de IA a cumplir la ley de derechos de autor sin concretar en qué consiste ese cumplimiento. El caso del TJUE podría convertirse en la clave judicial que otorgue un sentido práctico a esas obligaciones.
Nemitz considera que el argumento comercial de requerir un pago es obvio: “Que Google y sus competidores paguen por usar contenido protegido por derechos de autor debe convertirse en algo normal que no afectará en gran medida en su balance anual”, afirmó. En el caso de pequeños desarrolladores y start-ups, las empresas de concesión de licencias colectivas (que pueden negociar paquetes con muchos propietarios de derechos) ofrecerían una vía factible y proporcionada para el cumplimiento. Y como todos los desarrolladores de sistemas de IA basados en el lenguaje estarían sujetos a las mismas obligaciones, ninguna empresa ganaría una ventaja competitiva si se niega a pagar.
La estrategia de Google
Es posible que el caso de Balatonkörnyéke no sea el único. Una fuente al corriente del proceso judicial que desea permanecer en el anonimato, contó a EUrologus que otras dos demandas (las dos presentadas por Like Company en Hungría) siguen el mismo patrón de interpretación legal: una que incluye al sitio de noticias tecnológicas húngaro IT Café, y otra conocida como el caso Gamekapocs, presentada en 2023.
Según esta fuente, Google no se vio arrastrada a estos litigios, sino que la empresa identificó y buscó activamente este tipo de casos en Hungría. La empresa de Mountain View llevó a cabo una técnica que consiste en conseguir que un caso vaya por la vía rápida al Tribunal de Justicia de la UE en Luxemburgo.
La explicación, según la fuente, está clara: Hungría no tiene mucha práctica jurídica en litigios relacionados con la IA, así que se trata de una jurisdicción más flexible en la que probar sus argumentos antes de alcanzar el nivel europeo.
Por lo tanto, la pregunta ahora es qué gana Google de todo esto en la escala europea. Una posible respuesta, y sustentada por los hechos, es que en un litigio similar en Alemania entre Google y la empresa de gestión de derechos Corint Media, Google ya ha utilizado su éxito en el caso contra Gamekapocs en el marco de un procedimiento de arbitraje, alegando, en esencia, que ya existe un precedente en la legislación europea a nivel de Estado miembro.
Una dura prueba institucional
El caso Like Company empezó con una imagen absurda, conjurada y adornada por un chatbot: delfines en el lago Balatón. Sin embargo, bajo esa capa de ridiculez yace una dura prueba institucional. Europa ha establecido normativas ambiciosas para las plataformas, los mercados y la inteligencia artificial. Ahora, sus jueces deben decidir si esas normas van a seguir protegiendo el periodismo y la cultura cuando las máquinas no solo se dediquen a indexar la web, sino también a hablar en su lugar.
La opinión del Abogado General del TJUE está prevista el 3 de septiembre, y la decisión final se espera a finales de este año. Para Paul Nemitz, la decisión del tribunal dependerá, en última instancia, de un simple hecho: ningún gran modelo de lenguaje puede ser rentable (en Europa o cualquier otro sitio) sin recurrir a material europeo protegido por derechos de autor para entrenarlo. Y añade: “Ahí es donde está la ventaja”.
El etiquetado de contenido generado por IA entra en vigor en la UE
El 2 de agosto entró en vigor una cláusula del reglamento de Inteligencia Artificial que obliga a las empresas a etiquetar el contenido generado o manipulado por IA. La medida exige a los implementadores de sistema de IA que divulguen dos categorías de contenido: los deepfakes (definidos como “contenido de imagen, audio o vídeo generado o manipulado por IA que se asemeja a personas, objetos, lugares, entidades o eventos existentes y que le parecería falsamente a una persona que es auténtica o veraz”) y los textos generados o manipulados con IA publicados para informar sobre asuntos de interés público en los que no se haya llevado a cabo ninguna revisión humana ni control editorial y en los que ninguna persona física o jurídica asumió la responsabilidad editorial. La divulgación puede realizarse mediante marcas de agua u otros marcadores que permitan detectarlo con facilidad. El incumplimiento conlleva multas considerables.
🤝 Este artículo forma parte del proyecto colaborativo PULSE. György Folk (EUrologus/HVG, Budapest) ha contribuido en gran medida.
O
¿Aprecias nuestro trabajo?
Ayúdanos a sacar adelante un periodismo europeo y multilingüe, en acceso libre y sin publicidad. Tu donación, puntual o mensual, garantiza la independencia de la redacción. ¡Gracias!