



Scegli la lingua
Un cantante pop, un progetto per portare i delfini nel lago Balaton e una testata ungherese sconosciuta alla quasi totalità degli europei: a prima vista, la causa tra Like Company e Google Ireland somiglia più a un’argomento da tabloid che un contenzioso destinato a segnare il futuro digitale del giornalismo europeo.
Eppure questa vicenda singolare, attualmente all’esame della Corte di giustizia dell’Unione europea (Cgue), potrebbe stabilire fino a che punto le grandi aziende tecnologiche (le cosiddette “Big Tech”) possano spingersi nell’utilizzare i contenuti dei giornali per sviluppare e addestrare i propri sistemi di intelligenza artificiale (ia) senza alcuna autorizzazione né compenso.
Come riferito dalla rivista ungherese Hvg, la vicenda ha inizio con un articolo pubblicato nel luglio 2023 da Balatonkörnyéke, un aggregatore di notizie locali magiaro. Il pezzo raccontava che Kozsó, noto cantautore ungherese, non aveva abbandonato l’idea di introdurre i delfini nel lago Balaton. In seguito, un utente ha chiesto a Gemini, chatbot di Google, di riassumere l’articolo. Il sistema ha così generato una risposta articolata in più paragrafi, descrivendo il presunto progetto, le sue potenziali ricadute turistiche e le polemiche sollevate. Tuttavia, secondo il Tribunale regionale di Budapest, la risposta includeva anche dettagli del tutto assenti nel testo originale. Il giudice ha quindi rinviato il caso alla Corte di giustizia dell’Ue il 3 aprile 2025.
La posta in gioco va ben oltre l’aspetto aneddotico. Il 10 marzo 2026, la Grande sezione della Corte di giustizia dell’Ue ha tenuto quella che molti esperti di diritto considerano la prima udienza della Corte interamente incentrata sul legame tra intelligenza artificiale e diritto d’autore. Al centro del dibattito c’è una questione che da anni contrappone editori, artisti e colossi dell’ia: quando un sistema di intelligenza artificiale viene addestrato su contenuti protetti e successivamente genera risposte basandosi su di essi, viola il diritto d’autore?
I modelli linguistici di grandi dimensioni (Large Language Models, Llm) vengono addestrati su immensi volumi di dati che includono libri, articoli, siti web e altro materiale. Le aziende del settore sostengono che questo processo sia indispensabile per sviluppare strumenti d’ia efficaci e che rientri a pieno titolo nelle eccezioni normative concepite per promuovere ricerca e innovazione.
Le argomentazioni di Google e del settore dell’informazione
La tesi di Google è, in sostanza, che il suo modello di intelligenza artificiale non funziona come un archivio che conserva documenti, ma apprende modelli statistici. Il sistema scompone il testo in frammenti, ne individua le relazioni morfosintattiche e le codifica nei propri parametri. In quest’ottica, sostiene l’azienda, la generazione di una risposta non comporta alcuna “copia” del testo originale. Il sistema si limita a prevedere il linguaggio.
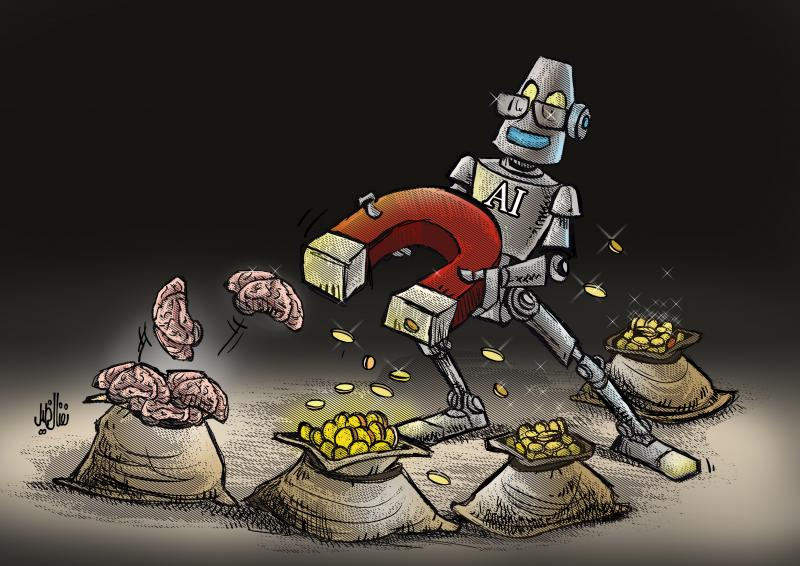
Editori e giornalisti la vedono diversamente e sottolineano come le proprie opere vengano elaborate e impiegate dai sistemi di ia per sviluppare prodotti capaci di rispondere in modo esaustivo alla domande dei lettori, azzerando la necessità di consultare le fonti primarie. Se nel tradizionale modello dei motori di ricerca Google garantiva comunque un flusso di traffico verso le testate, seppure in modo sbilanciato, nella nuova “economia delle risposte”, le piattaforme tendono a trattenere sempre più gli utenti all’interno delle proprie interfacce digitali. In questo modo evitano di generare visite proprio verso i siti web da cui hanno attinto le informazioni.
La questione economica si pone quindi inevitabilmente: che valore ha il lavoro di un giornalista se lettori e lettrici ottengono dalle ia dei motori di ricerca delle risposte esaustive anziché un rinvio alla fonte originale? Editori, giornalisti e autori sostengono inoltre che le loro opere vengono utilizzate senza autorizzazione né compenso, in particolare quando i contenuti generati dall’ia sono molto simili ai testi originali o finiscono per far loro concorrenza diretta.
L’ordinamento europeo dispone già di strumenti giuridici applicabili a queste situazioni, sebbene nessuno sia stato concepito pensando ai chatbot di oggi. Se una direttiva del 2001 riserva ai titolari dei diritti il controllo esclusivo sulla riproduzione e diffusione delle proprie opere, la successiva direttiva del 2019 ha introdotto specifiche deroghe per l’estrazione di testo e dati (text and data mining).
Queste consentono l’elaborazione automatizzata di enormi volumi di contenuti, anche su materiale liberamente accessibile sul web, salvo esplicito ricorso alla clausola di esenzione (opt-out) da parte dei titolari di diritti. La portata effettiva di queste eccezioni resta, tuttavia, ancora da definire sul piano giurisprudenziale, soprattutto quando l’intelligenza artificiale viene impiegata per fini commerciali.
Tre possibili scenari
La causa intentata da Like Company potrebbe costringere la Corte a chiarire i limiti di questi confini. Se i giudici dovessero stabilire che l’addestramento dei sistemi di ia costituisce a tutti gli effetti una forma di riproduzione ai sensi del diritto d’autore europeo, gli sviluppatori saranno tenuti a procurarsi apposite licenze, rispettare le clausole di opt-out o fare affidamento su specifiche eccezioni. Se invece i giudici decidessero che l’addestramento delle ia esula completamente dal copyright, crollerebbe una delle argomentazioni legali più solide mosse dagli editori.
Una terza opzione, incentrata sui risultati delle richieste fatte all’ia, imporrebbe alla Corte di stabilire quando la risposta di un chatbot sia sufficientemente simile a un articolo protetto da costituire una violazione del diritto d’autore. Il servizio di ricerca del Parlamento europeo ha già rilevato che l’addestramento dei modelli dell’ia per uso generale si basa su enormi quantità di dati che possono includere materiale protetto e come il diritto europeo abbia sancito sia diritti esclusivi sia relative eccezioni volte a disciplinare questo processo.
“Il fatto che Google e i suoi concorrenti paghino per l’uso di materiale protetto da copyright deve diventare la norma, e avrà comunque un’incidenza microscopica sui loro bilanci” – Paul Nemitz
Per Paul Nemitz, esperto di digitalizzazione e docente al Collegio d’Europa, la posta in gioco per i mezzi d’informazione indipendenti non potrebbe essere più alta: “Se la Corte dovesse accogliere le argomentazioni di Google, anche solo in parte, l’editoria e l’informazione privata in Europa sono condannate”, avverte. “Sopravviveranno soltanto i media pubblici. In questo modo verrebbe fatta fuori la forza innovativa della cultura e del pensiero critico per la democrazia, il cui principio fondamentale è che la strada verso il cambiamento deve rimanere aperta”.
A suo avviso il diritto europeo fornisce già il quadro normativo adeguato: “Da un lato una forte tutela del diritto d’autore per le opere la cui novità è tale da essere riconosciute come espressione del genio umano; dall’altro un’eccezione al copyright per l’estrazione di testo e dati”. Quest’ultima deroga, sottolinea Nemitz, era stata pensata per favorire il progresso scientifico, non certo per consentire lo sfruttamento su ampia scala di contenuti giornalistici e culturali da parte di sistemi di ia commerciali. Qualsiasi interpretazione della norma, insiste l’esperto, deve pertanto essere letta alla luce dei diritti fondamentali dell’Ue e della funzione democratica svolta dal giornalismo indipendente.
Dal canto suo, la European Copyright Society, che riunisce i principali giuristi ed esperti europei del settore, invita alla prudenza. A suo giudizio, chatbot, modelli di ia e motori di ricerca implicano operazioni tecniche e giuridiche nettamente distinte e non dovrebbero essere riuniti in un’unica categoria. L’associazione mette inoltre in guardia contro una sentenza troppo generica, che rischierebbe di favorire un mercato delle licenze accessibile solo ai colossi dell’ia, pur riconoscendo che l’uso non autorizzato di contenuti protetti è comunque preoccupante.
Un momento delicato
Le tempistiche sono tutt’altro che casuali. L’Unione europea sta già attuando il suo Artificial Intelligence Act, un regolamento che impone ai fornitori di modelli di intelligenza artificiale di grandi dimensioni di adottare politiche per rispettare il diritto d’autore, applicare le clausole di opt-out dei titolari di diritti e pubblicare sintesi dei contenuti impiegati per l’addestramento delle ia.
La legge non risolve però la questione di fondo: chiede alle aziende di conformarsi alla legge sul copyright senza precisare cosa questo comporti nei fatti. La causa all’esame della Cgue potrebbe così diventare lo snodo giurisprudenziale che darà un significato operativo a questi obblighi.
Secondo Nemitz l’argomento economico a favore dell'obbligo di compensare editori e creatori di contenuti è lineare: “Il fatto che Google e i suoi concorrenti paghino per l’uso di materiale protetto da copyright deve diventare la norma, e avrà comunque un’incidenza microscopica sui loro bilanci”, spiega.
Per gli sviluppatori più piccoli e le startup, le società di gestione collettiva dei diritti, che sono capaci di negoziare accordi complessivi per conto di una pluralità di autori, offrirebbero una soluzione proporzionata e praticabile per mettersi in regola. E poiché tutti gli sviluppatori di sistemi di ia basati sul linguaggio dovrebbero sottostare ai medesimi requisiti, nessuna azienda trarrebbe un vantaggio competitivo rifiutandosi di pagare.
La strategia di Google
La vicenda di Balatonkörnyéke potrebbe non essere un episodio isolato. Una fonte informata sui fatti, che ha chiesto l’anonimato, ha riferito a EUrologus che altre due cause, entrambe avviate in Ungheria da Like Company, seguono un modello giuridico analogo: una riguarda IT Café, una testata tecnologica ungherese, l’altra è nota come il caso Gamekapocs, intentato nel 2023. In quest’ultima decisione la Corte d’appello di Budapest ha stabilito che il sito ungherese specializzato nel gaming non aveva esercitato il suo opt-out nelle forme previste dalla legge, e che quindi Google aveva il diritto di usare i suoi contenuti.
Secondo la medesima fonte, Google non si sarebbe limitata a subire passivamente questi contenziosi, ma avrebbe identificato e portato avanti attivamente casi di questo tipo in Ungheria. Il motivo, spiega la fonte, è che, facendo ricorso a una tecnica detta di “court district shopping”, scegliendo cioè una giurisdizione a priori meno agguerrita come quelle ungheresi, l’azienda di Mountain View punta a testare le proprie argomentazioni e, se possibile, a ottenere decisioni favorevoli che può presentare poi come precedenti dinanzi alla Corte di Lussemburgo.
Un esempio di questa strategia giunge da una controversia analoga in corso in Germania tra il colosso americano e la società di gestione dei diritti Corint Media: in quella sede, Google ha già speso a proprio favore la vittoria ottenuta contro Gamekapocs, sostenendo in sostanza che c’è già un precedente di diritto europeo a livello di uno stato membro.
Un banco di prova per le istituzioni
La causa intentata da Like Company nasce da un’immagine assurda: dei delfini nel lago Balaton, evocati e abbelliti da un chatbot. Ma sotto l’apparente assurdità si cela un test istituzionale decisivo. L’Europa ha costruito un impianto normativo ambizioso per regolare piattaforme, mercati e intelligenza artificiale. Ora spetta ai suoi giudici in Lussemburgo stabilire se quelle stesse norme siano ancora in grado di tutelare il giornalismo e la cultura in un’epoca in cui le macchine non si limitano più a indicizzare il web, ma parlano al suo posto.
Le conclusioni dell’avvocato generale della Cgue sono attese per il 3 settembre, mentre la sentenza definitiva dovrebbe arrivare entro la fine dell'anno. Per Paul Nemitz la decisione dei giudici si ridurrà in ultima analisi a una realtà ineludibile: nessuna ia generativa può generare profitti, in Europa o nel resto del mondo, senza attingere per il proprio addestramento a materiale europeo protetto da copyright. “È proprio lì”, conclude l’esperto, “che risiede il vero margine di manovra”.
Entra in vigore nell’UE l’obbligo di contrassegnare i contenuti generati dall’IA
Dal 2 agosto è entrata in vigore la disposizione dell’AI Act che impone alle aziende di contrassegnare come tali i contenuti generati o manipolati dall’IA. La misura richiede ai gestori di sistemi di IA di indicare due categorie di contenuti: i deepfake – definiti come “contenuti di immagini, audio o video generati o manipolati dall’intelligenza artificiale che assomigliano a persone, oggetti, luoghi, entità o eventi esistenti e che potrebbero essere erroneamente percepiti da una persona come autentici o veritieri” – e i testi generati o manipolati dall’intelligenza artificiale “pubblicati per informare il pubblico su questioni di interesse pubblico, laddove non sia stata effettuata alcuna revisione umana o controllo editoriale e laddove nessuna persona giuridica o fisica si sia assunta la responsabilità editoriale.” La divulgazione può avvenire tramite watermark o altri indicatori che li rendano facili da individuare. Il mancato rispetto di tali disposizioni comporta multe sostanziali.
🤝 Questo articolo è stato realizzato nell’ambito del progetto collaborativo PULSE. György Folk (EUrologus/Hvg, Budapest) ha collaborato alla sua stesura.
O
Ti piace quello che facciamo?
Contribuisci a far vivere un giornalismo europeo e multilingue, in accesso libero e senza pubblicità. La tua donazione, puntuale o regolare, garantisce l’indipendenza della nostra redazione. Grazie!