




Wählen Sie eine Sprache
Ein Popsänger, der Plan, Delfine an den Plattensee zu bringen, und eine ungarische Nachrichtenseite, von der nur wenige Europäer*innen je gehört haben: Auf den ersten Blick wirkt der Fall Like Company gegen Google Ireland eher wie Stoff für die Boulevardpresse als wie ein wegweisender Rechtsstreit um die digitale Zukunft des europäischen Journalismus. Doch dieser ungewöhnliche Fall, der nun vor dem Gerichtshof der Europäischen Union (EuGH) verhandelt wird, könnte darüber entscheiden, wie weit die Big Tech-Unternehmen bei der Nutzung von Presseinhalten zum Aufbau und Betrieb von Systemen der künstlichen Intelligenz (KI) ohne Genehmigung oder Bezahlung gehen dürfen.
Wie HVG berichtet, begann der Streit mit einem Artikel, der im Juli 2023 von Balaton Környeke, einer lokalen ungarischen Nachrichtenseite, veröffentlicht wurde. Darin hieß es, dass der bekannte ungarische Singer-Songwriter Kozsó seine Idee, Delfine im Plattensee anzusiedeln, nicht aufgegeben habe. Ein Leser bat den Gemini-Chatbot von Google später, den Artikel zusammenzufassen.
Der Chatbot generierte eine aus mehreren Absätzen bestehende Antwort, in der das angebliche Projekt, seine möglichen Auswirkungen auf den Tourismus und die damit verbundene Kontroverse beschrieben wurden. Doch laut dem Regionalgericht Budapest, das den Fall zunächst verhandelte, enthielt die Zusammenfassung auch Details, die im Originalartikel überhaupt nicht vorkamen. Das Gericht legte den Fall am 3. April 2025 dem EuGH vor.
Es geht um weit mehr als nur eine kuriose Geschichte. Am 10. März 2026 hielt die Große Kammer des EuGH eine mündliche Verhandlung ab, die von Rechtsexpert*innen, als die erste des Gerichts bezeichnet wurde, in der es direkt um KI und das EU-Urheberrecht ging. Im Mittelpunkt steht eine Frage, um die Verlage, Künstler*innen und KI-Unternehmen seit Jahren streiten: Gilt das Urheberrecht, wenn ein KI-System mit urheberrechtlich geschützten Inhalten trainiert wird und darauf basierende Antworten generiert?
Große Sprachmodelle (Large Language Models, LLMs) werden anhand riesiger Datensätze trainiert, die Bücher, Artikel, Websites und anderes schriftliches Material umfassen. KI-Unternehmen argumentieren, dass dieser Prozess für die Entwicklung nützlicher KI-Tools unerlässlich ist und unter gesetzliche Ausnahmeregelungen fällt, die der Förderung von Forschung und Innovation dienen.
Googles Argumente gegen die der Medienbranche
Googles Argument lautet im Wesentlichen, dass sein KI-Modell Artikel nicht so speichert, wie eine Datenbank Dokumente speichert. Stattdessen lernt es statistische Muster – indem es Text in Fragmente zerlegt, Zusammenhänge identifiziert und diese im System kodiert. Aus dieser Perspektive, so argumentiert das Unternehmen, werde nichts „kopiert“, wenn das System eine Antwort generiert. Es sage nur Sprache voraus.
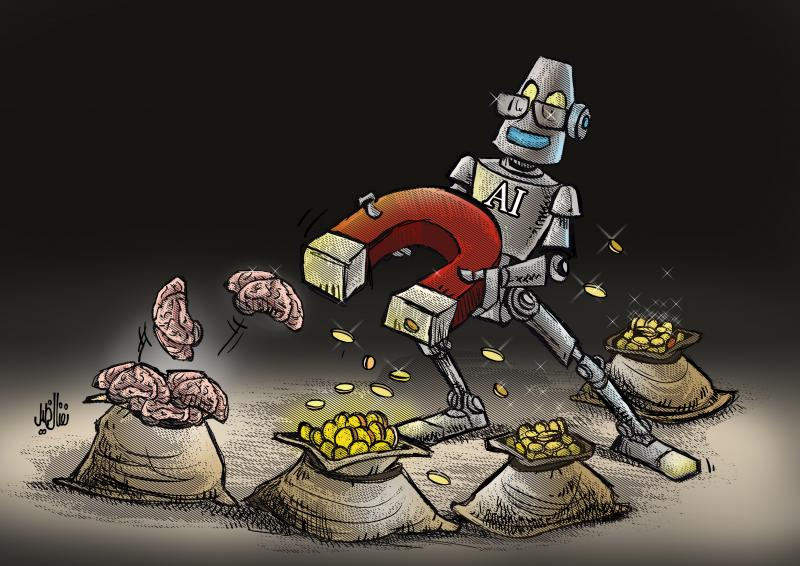
Verlage und Journalistinnen und Journalisten sehen das anders: Ihre Artikel werden von KI-Tools verarbeitet und genutzt, um Produkte zu entwickeln, die die Fragen der Leser*innen direkt beantworten. Dadurch wird die Originalquelle weniger häufig aufgerufen. In der alten Suchökonomie leitete Google den Traffic an die Verlage weiter, wenn auch in ungleicher Verteilung. In der sich entwickelnden Antwortökonomie könnten Plattformen die Nutzer*innen zunehmend innerhalb ihrer eigenen Benutzeroberflächen halten – und so vermeiden, Web-Traffic auf eben den Websites zu generieren, von denen sie die relevanten Informationen beziehen.
Daraus ergibt sich zwangsläufig die Frage: Welchen Wert hat die Arbeit eines Journalisten oder einer Journalistin, wenn die Leser*innen statt eines Links eine fertige Antwort erhalten? Verlage, Journalist*innen und Autor*innen argumentieren zudem, dass ihre Werke ohne Genehmigung oder Vergütung genutzt werden, insbesondere wenn KI-Systeme Ergebnisse generieren, die den Originalinhalten sehr ähnlich sind oder mit ihnen konkurrieren.
Das europäische Recht enthält bereits Paragrafen, die für diesen Konflikt relevant sind, auch wenn keiner davon mit Blick auf die heutigen Chatbots verfasst wurde. Eine Richtlinie aus dem Jahr 2001 etwa räumt Rechteinhaber*innen die Kontrolle über die Vervielfältigung und Verbreitung ihrer Werke ein. Eine Richtlinie aus dem Jahr 2019 führte jedoch Ausnahmen ein, die Text- und Data-Mining – die automatisierte Verarbeitung großer Mengen von Inhalten – auch bei frei zugänglichem Material erlauben, sofern die Rechteinhaber*innen nicht ausdrücklich widersprechen. Doch die Grenzen dieser Ausnahmen, vorwiegend im kommerziellen KI-Kontext, sind rechtlich noch nicht geprüft.
Drei mögliche Ergebnisse
Der Fall „The Like Company“ könnte das Gericht dazu zwingen, zu klären, wo diese Grenzen liegen. Sollten die Richterinnen und Richter entscheiden, dass das Trainieren von KI nach dem EU-Urheberrecht eine Vervielfältigung darstellt, benötigen Entwickler*innen möglicherweise Lizenzen, müssen Einsprüche respektieren oder sich auf bestimmte Ausnahmen stützen. Sollten sie entscheiden, dass das Trainieren gänzlich außerhalb des Urheberrechts liegt, könnte eines der stärksten rechtlichen Argumente der Verlage wegfallen.
Ein dritter Ansatz, der sich auf die Ergebnisse der KI konzentriert, würde erfordern, dass das Gericht entscheidet, wann die Antwort eines Chatbots einem geschützten Werk so ähnlich ist, dass eine Rechtsverletzung vorliegt. Der wissenschaftliche Dienst des Europäischen Parlaments hat darauf hingewiesen, dass das Training von Allzweck-KI auf großen Datensätzen beruht, die urheberrechtlich geschütztes Material enthalten können. Auch weist er darauf hin, dass das EU-Recht sowohl ausschließliche Rechte als auch Ausnahmen geschaffen hat, die für diesen Prozess relevant sind.
Für Paul Nemitz, Digitalisierungsexperte und Gastprofessor am College of Europe, steht für unabhängige Medien mehr auf dem Spiel denn je. „Sollte das Gericht den Argumenten von Google auch nur teilweise folgen, sind private Medien und Verlage in Europa am Ende“, warnt er. „Nur staatliche Medien werden überleben. Auf diese Weise würde die Innovationskraft der Kultur und der Demokratie, in der der Weg für Veränderungen offen sein muss, als oberstes Prinzip zunichtegemacht.“
Das EU-Recht biete seiner Ansicht nach bereits den richtigen Rahmen: „Einerseits einen starken Urheberrechtsschutz für Werke, die neu genug sind, um als Ausdruck menschlichen Genies anerkannt zu werden, und andererseits eine Ausnahme vom Urheberrecht für Text- und Datenauswertung.“ Diese Ausnahme sei dazu gedacht, wissenschaftlichen Fortschritt zu ermöglichen und nicht, um die groß angelegte Extraktion journalistischer und kultureller Inhalte durch kommerzielle KI-Systeme zuzulassen. Jede Auslegung dieser Ausnahme müsse, so betont er, im Zusammenhang mit dem Grundrechtsrahmen der EU und der demokratischen Funktion des unabhängigen Journalismus betrachtet werden.
Die European Copyright Society, zu deren Mitgliedern führende Wissenschaftler*innen im Bereich des Urheberrechts zählen, hat zur Vorsicht gemahnt. Ihrer Ansicht nach beinhalten Chatbots, KI-Modelle und Suchmaschinen unterschiedliche technische und rechtliche Abläufe und sollten nicht als eine einzige Kategorie behandelt werden. Sie warnt zudem vor einer Entscheidung, die so weit gefasst ist, dass sie einen Lizenzmarkt schafft, der nur den größten KI-Anbietern dient – räumt jedoch gleichzeitig ein, dass die nicht lizenzierte Nutzung geschützter Inhalte ernsthafte Bedenken aufwirft.
Ein heikler Zeitpunkt
Der Zeitpunkt ist dabei von Bedeutung. Die EU setzt bereits ihr Gesetz über künstliche Intelligenz um, das Anbieter großer KI-Modelle dazu verpflichtet, Richtlinien zur Einhaltung des Urheberrechts zu verabschieden, das Widerspruchsrecht der Rechteinhaber*innen zu respektieren und Zusammenfassungen der für das Training verwendeten Inhalte zu veröffentlichen. Das Gesetz löst jedoch nicht die zugrunde liegende urheberrechtliche Frage. Es fordert KI-Unternehmen lediglich auf, das Urheberrecht einzuhalten, ohne konkret zu spezifizieren, was diese Einhaltung erfordert. Das Urteil des EuGH könnte der juristische Schlüssel sein, der diesen Verpflichtungen ihre praktische Bedeutung verleiht.
Nemitz befürwortet ausdrücklich eine Zahlungspflicht: „Dass Google und seine Konkurrenten für die Nutzung urheberrechtlich geschützten Materials zahlen, muss zur Normalität werden und wird in ihrer Bilanz auch nur wenig zu Buche schlagen“, sagte er. Für kleinere Entwickler*innen und Start-ups würden Verwertungsgesellschaften – die Pauschalvereinbarungen mit vielen Rechteinhaber*innen aushandeln können – einen angemessenen und praktikablen Weg zur Einhaltung der Vorschriften bieten. Und da alle Entwickler sprachbasierter KI-Systeme denselben Anforderungen unterliegen würden, könnte sich kein Unternehmen durch die Verweigerung von Zahlungen einen Wettbewerbsvorteil verschaffen.
Googles Strategie
Der Fall „Balaton Környéke“ ist möglicherweise kein Einzelfall. Eine mit dem Verfahren vertraute Quelle, die anonym bleiben wollte, teilte EUrologus mit, dass zwei weitere Klagen – beide von der Like Company in Ungarn eingereicht – einem ähnlichen Muster der Rechtsauslegung folgen: eine betrifft IT Café, eine ungarische Technologie-Nachrichtenseite, und eine weitere, bekannt als der „Gamekapocs“-Fall, wurde 2023 eingereicht.
Laut dieser Quelle wurde Google nicht einfach in diese Streitigkeiten hineingezogen – das Unternehmen hat Fälle dieser Art in Ungarn aktiv ausfindig gemacht und verfolgt. Das Unternehmen aus Mountain View wandte eine Technik namens „Court District Shopping“ an, mit dem Ziel, eine beschleunigte Bearbeitung seines Falles vor dem Europäischen Gerichtshof in Luxemburg zu erreichen.
Die Begründung ist laut der Quelle einfach: In Ungarn gibt es relativ wenig etablierte Rechtspraxis bei Streitigkeiten im Zusammenhang mit KI, was das Land zu einer flexibleren Gerichtsbarkeit macht, in der Argumente getestet werden können, bevor sie die EU-Ebene erreichen.
Dies wirft natürlich die Frage auf, was Google auf EU-Ebene davon hat. Eine durch Fakten gestützte Antwort lautet, dass Google in einem ähnlichen Rechtsstreit in Deutschland zwischen Google und einer Verwertungsgesellschaft namens Corint Media seinen erfolgreichen Fall gegen Gamekapocs bereits in ein Schiedsverfahren eingebracht hat und dabei im Wesentlichen argumentiert: Seht her, es gibt bereits einen Präzedenzfall nach EU-Recht auf Ebene der Mitgliedstaaten.
Eine harte institutionelle Bewährungsprobe
Der Fall „Like Company“ begann mit einem absurden Bild: Delfine im Plattensee, die von einem Chatbot bewundert und noch schöner gemacht wurden. Doch hinter diesem absurden Szenario verbirgt sich eine harte institutionelle Bewährungsprobe. Europa hat ehrgeizige Vorschriften für Plattformen, Märkte und künstliche Intelligenz geschaffen. Nun müssen die EU-Richterinnen und Richter entscheiden, ob diese Vorschriften Journalismus und Kultur auch dann noch schützen können, wenn Maschinen das Internet nicht mehr nur indexieren, sondern an dessen Stelle sprechen.
Die Stellungnahme des Generalanwalts des EuGH ist für den 3. September vorgesehen, das endgültige Urteil wird noch in diesem Jahr erwartet. Für Paul Nemitz wird die Entscheidung des Gerichts letztlich auf einer einfachen Tatsache beruhen: Kein großes Sprachmodell kann – weder in Europa noch anderswo auf der Welt – rentabel sein, ohne für sein Training auf europäisches urheberrechtlich geschütztes Material zurückzugreifen. „Genau darin“, sagt er, „liegt der Schlüssel.“
KI-Kennzeichnungspflicht in der EU in Kraft getreten
Am 2. August trat die Bestimmung des KI-Gesetzes in Kraft, wonach Unternehmen KI-generierte oder manipulierte Inhalte als solche kennzeichnen müssen. Die Maßnahme verpflichtet Betreiber*innen von KI-Systemen, zwei Kategorien von Inhalten offenzulegen: Deepfakes – definiert als „KI-generierte oder manipulierte Bild-, Audio- oder Videoinhalte, die bestehenden Personen, Objekten, Orten, Einrichtungen oder Ereignissen ähneln und einer Person fälschlicherweise als authentisch oder wahrhaftig erscheinen würden.“ Außerdem KI-generierte oder manipulierte Texte, die zur Information der Öffentlichkeit über Angelegenheiten von öffentlichem Interesse veröffentlicht werden, bei denen keine menschliche Überprüfung oder redaktionelle Kontrolle stattfand und bei denen keine juristische oder natürliche Person die redaktionelle Verantwortung übernommen hat. Die Kennzeichnung kann durch Wasserzeichen oder andere Markierungen erfolgen, die eine einfache Erkennung ermöglichen. Bei Nichteinhaltung drohen erhebliche Geldbußen.
🤝 Dieser Artikel ist im Rahmen des Kooperationsprojekts PULSE entstanden. György Folk (EUrologus/HVG, Budapest) hat maßgeblich dazu beigetragen.
O
Schätzen Sie unsere Arbeit?
Dann helfen Sie uns, multilingualen europäischen Journalismus weiterhin frei zugänglich anbieten zu können. Ihre einmalige oder monatliche Spende garantiert die Unabhängigkeit unserer Redaktion. Danke!