







Afficher l'article dans votre langue
Un chanteur pop, un projet visant à introduire des dauphins dans le lac Balaton et un site d’actualité hongrois inconnu de la plupart des Européens : à première vue, l’affaire Like Company c. Google Ireland ressemble davantage à un sujet de presse people qu’à un contentieux dont l'issue pourrait déterminer l’avenir numérique du journalisme européen. Pourtant, cette affaire improbable, désormais portée devant la Cour de justice de l’Union européenne (CJUE), pourrait décider dans quelle mesure les “Big Tech” sont autorisées à utiliser des contenus journalistiques pour développer et exploiter des systèmes d’intelligence artificielle (IA) sans autorisation ni rémunération.
Selon l'hebdomadaire hongrois HVG, le litige a débuté avec un article publié en juillet 2023 par Balatonkornyeke, un agrégateur d’actualités locales hongrois. L’article indiquait que Kozsó, un auteur-compositeur-interprète très populaire en Hongrie, n’avait pas abandonné son idée d’introduire des dauphins dans le lac Balaton. Un utilisateur a ensuite demandé au chatbot Gemini de Google de résumer cet article.
Le chatbot a généré une réponse de plusieurs paragraphes décrivant le projet présumé, son impact touristique potentiel et la controverse qui l’entourait – mais, selon le tribunal régional de Budapest, qui a été le premier à examiner l’affaire, cette réponse comprenait également des détails qui ne figuraient absolument pas dans l’article original. Le tribunal a saisi la CJUE de l’affaire le 3 avril 2025.
Les enjeux vont bien au-delà d’une simple histoire de réponse trompeuse générée par IA – une “hallucination”. Le 10 mars 2026, la Grande Chambre de la CJUE a tenu sa première audience orale de la Cour traitant directement de l’IA et du droit d’auteur de l’UE. Au cœur de cette affaire se trouve une question qui oppose depuis des années les éditeurs, les artistes et les entreprises spécialisées dans l’IA : lorsqu’un système d’IA est entraîné sur des contenus protégés et produit par la suite des réponses basées sur ceux-ci, le droit d’auteur s’applique-t-il ?
Les grands modèles linguistiques (LLM) sont entraînés à partir de vastes ensembles de données comprenant des livres, des articles, des sites web et d’autres documents écrits. Les entreprises spécialisées dans l’IA font valoir que ce processus est essentiel pour développer des outils d’IA efficaces et qu’il relève des exceptions légales destinées à promouvoir la recherche et l’innovation.
Les arguments de Google et du secteur des médias
L’argument de Google repose essentiellement sur le fait que son modèle d’IA ne stocke pas les articles de la même manière qu’une base de données stocke des documents. À la place, il apprend des schémas statistiques : il décompose le texte en fragments, identifie les relations et les encode dans le système. De ce point de vue, affirme l’entreprise, rien n’est “copié” lorsque le système génère une réponse : il prédit le langage.
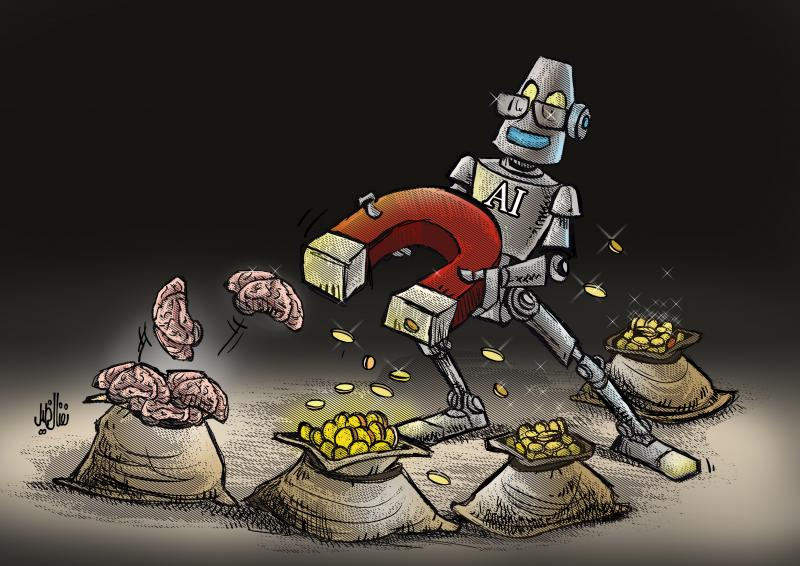
Les médias et les journalistes voient les choses différemment : leurs articles sont traités et utilisés par des outils d’IA pour créer des produits qui répondent directement aux questions des lecteurs – réduisant ainsi la nécessité de consulter la source originale. Dans l’ancienne “économie de la recherche”, Google redirigeait le trafic vers les médias, même si c’était de manière inégale. Dans l’“économie de la réponse” émergente, les plateformes pourraient de plus en plus retenir les utilisateurs au sein de leurs propres interfaces – évitant ainsi de générer du trafic vers les sites web d’où elles tirent les informations pertinentes.
La France face à l’intelligence artificielle
Fin juillet 2026, Google a déployé en France les résumés par IA des résultats de son moteur de recherche – la fonction au centre du contentieux qu’examine la CJUE. La réaction de la sphère médiatique ne s’est pas faite attendre : le 11 août, l’Alliance de la presse d’information générale (APIG), qui regroupe près de 300 quotidiens français, a annoncé être passée à l’offensive devant l’Autorité de la concurrence. L’APIG demande à l’Autorité de la concurrence d’intervenir “pour demander le respect par Google des engagements pris en 2022”, car, estime-t-elle, “le déploiement unilatéral de nouveaux usages des contenus de presse, sans autorisation préalable ni rémunération dédiée, méconnaît ces engagements”, rapporte Le Monde.
La question économique s’impose alors naturellement : quelle est la valeur du travail d’un journaliste si les lecteurs reçoivent une réponse toute faite au lieu d’un lien ? Les médias, les journalistes et les auteurs font également valoir que leur travail est utilisé sans autorisation ni rémunération, en particulier lorsque les systèmes d’IA génèrent des résultats qui ressemblent fortement au contenu original ou qui lui font concurrence.
Le droit européen dispose déjà d’outils adaptés à ce conflit, bien que ceux-ci n’aient pas été conçus en pensant aux chatbots d’aujourd’hui. Une directive de 2001 confère aux titulaires de droits le contrôle de la reproduction et de la communication de leurs œuvres. Une directive de 2019 a introduit des exceptions autorisant l’exploration de textes et de données – le traitement automatisé de grands volumes de contenu –, y compris sur des documents librement accessibles, à moins que les titulaires de droits ne s’y opposent explicitement. Mais les limites de ces exceptions, en particulier dans les contextes commerciaux liés à l’IA, n’ont pas encore été testées sur le plan juridique.
Trois issues possibles
L’affaire Like Company pourrait contraindre la Cour à clarifier où se situent ces limites. Si les juges estiment que l’entraînement de l’IA constitue une reproduction au sens du droit d’auteur de l’UE, les développeurs pourraient devoir obtenir des licences, respecter les refus d’autorisation ou s’appuyer sur des exceptions spécifiques. S’ils jugent au contraire que l’entraînement des IA ne relève pas du tout du droit d’auteur, l’un des arguments juridiques les plus solides des médias pourrait disparaître.
Une troisième voie – axée sur les résultats générés par l’IA – exigerait que la Cour détermine à partir de quand la réponse d’un chatbot est suffisamment proche d’un article protégé pour constituer une violation du droit d'auteur. Le Service de recherche du Parlement européen a noté que l’entraînement d’une IA à usage général repose sur de vastes ensembles de données pouvant inclure des contenus protégés par le droit d’auteur, et que le droit de l’Union européenne a établi à la fois des droits exclusifs et des exceptions applicables à ce processus.
“Si la Cour suit les arguments de Google, ne serait-ce qu’en partie, les médias d’information privés et l’édition privée en Europe sont condamnés” – Paul Nemitz
Pour Paul Nemitz, expert du numérique et professeur invité au Collège d’Europe, les enjeux pour les médias indépendants ne pourraient être plus importants. “Si la Cour suit les arguments de Google, ne serait-ce qu’en partie, les médias d’information privés et l’édition privée en Europe sont condamnés”, prévient-il. “Seuls les médias publics survivront. Ainsi, la force d’innovation de la culture et de la critique au service de la démocratie, dont le principe fondamental est d’ouvrir la voie au changement, aurait été anéantie.”
Selon lui, le droit de l’Union européenne fournit déjà le cadre adéquat : “D’une part, une protection solide du droit d’auteur pour les œuvres suffisamment nouvelles pour être reconnues comme l’expression du génie humain, et d’autre part, une exception au droit d’auteur relative à l’exploration de textes et de données”.
Cette exception a été conçue pour permettre le progrès scientifique – et non pour autoriser l’extraction à grande échelle de productions journalistiques et culturelles par des systèmes d’IA à but commercial. Toute interprétation de cette exception, insiste-t-il, doit être considérée à l’aune du cadre des droits fondamentaux de l’UE et de la fonction démocratique du journalisme indépendant.
La Société européenne du droit d’auteur, qui compte parmi ses membres d’éminents universitaires spécialisés dans le droit d’auteur, a appelé à la prudence. Selon elle, les chatbots, les modèles d’IA et les moteurs de recherche impliquent des opérations techniques et juridiques différentes et ne devraient pas être regroupés dans une seule et même catégorie.
Elle met également en garde contre toute décision si vague qu’elle créerait un marché des licences au service exclusif des plus grands fournisseurs d’IA – tout en reconnaissant que l’utilisation sans licence de contenus protégés soulève de sérieuses interrogations.
Un moment délicat
Le moment choisi est significatif. L’UE met déjà en œuvre sa loi sur l’intelligence artificielle, qui impose aux fournisseurs de grands modèles d’IA d’adopter des politiques de conformité en matière de droit d’auteur, de respecter les options de retrait des titulaires de droits et de publier des résumés des contenus utilisés pour l’entraînement.
Mais cette loi ne résout pas la question sous-jacente du droit d’auteur : elle enjoint aux entreprises d’IA de se conformer à la législation sur le droit d’auteur sans préciser ce qu’implique cette conformité. L’affaire portée devant la CJUE pourrait devenir la clé juridique qui donnera à ces obligations leur signification concrète.
Pour Paul Nemitz, l’argument commercial en faveur de l’obligation de rémunération est simple : “Le fait que Google et ses concurrents paient pour l’utilisation de contenus protégés par le droit d’auteur doit devenir la norme et ne représentera qu’un montant négligeable dans leur bilan”, assure-t-il.
Pour les petits développeurs et les start-ups, les sociétés de gestion collective – qui peuvent négocier des accords globaux avec de nombreux titulaires de droits – offriraient une voie proportionnée et viable vers la conformité. Et comme tous les développeurs de systèmes d’IA basés sur le langage seraient soumis aux mêmes exigences, aucune entreprise ne bénéficierait d’un avantage concurrentiel en refusant de payer.
La stratégie de Google
L’affaire Balatonkornyeke n’est peut-être pas un épisode isolé. Une source au fait de la procédure, qui a souhaité garder l’anonymat, a déclaré à EUrologus que deux autres poursuites judiciaires – toutes deux intentées par la société Like en Hongrie – suivaient un schéma d’interprétation juridique similaire : l’une concernant IT Café, un site d’actualités technologiques hongrois, et l’autre, connue sous le nom d’affaire Gamekapocs, intentée en 2023.
Dans cet arrêt, la Cour d'appel de Budapest a estimé que le site hongrois consacré aux jeux vidéos n'avait pas exercé son droit de refus concernant l'exploration de textes et de données selon les modalités prévues par la loi, ce qui signifie que Google avait le droit d’extraire et d’indexer son contenu, conformément à l’exception légale.
La raison, explique la source, est qu’en recourant à une technique dite de “court district shopping”, c’est-à-dire en choisissant a priori une juridiction moins aguerrie, comme celles hongroises, l’entreprise de Mountain View vise à tester ses arguments et, si possible, à obtenir des décisions favorables qu’elle pourra ensuite présenter comme des précédents devant la Cour de Luxembourg.
Un exemple de cette stratégie nous vient d’un litige similaire en cours en Allemagne entre le géant américain et la société de gestion des droits Corint Media : dans cette affaire, Google a déjà mis à profit la victoire remportée contre Gamekapocs, en faisant valoir en substance qu’il existait déjà un précédent en droit européen au niveau d’un Etat membre.
Un test institutionnel
L’affaire Like Company a débuté par une image absurde : des dauphins dans le lac Balaton, créés et embellis par un chatbot. Mais derrière cette absurdité se cache un test institutionnel de taille. L’Europe a mis en place des règles ambitieuses pour les plateformes, les marchés et l’intelligence artificielle. Ses juges doivent désormais décider si ces règles peuvent encore protéger le journalisme et la culture à l’heure où les machines ne se contentent plus d’indexer le Web, mais s’expriment à sa place.
Les conclusions de l’avocat général de la CJUE sont attendues le 3 septembre, l’arrêt définitif étant prévu dans le courant de l’année. Pour Paul Nemitz, la décision de la Cour reposera en fin de compte sur une réalité simple : aucun grand modèle de langage ne peut être rentable — en Europe ou ailleurs dans le monde — sans s’appuyer sur des contenus protégés par le droit d’auteur européen pour son apprentissage. “C’est là”, dit-il, “que réside le levier”.
L’obligation d'étiquetage des contenus générés par l’IA entre en vigueur dans l’UE
Depuis le 2 août, la disposition de la loi sur l'IA (AI Act) obligeant les entreprises à signaler comme tels les contenus générés ou manipulés par l'IA est entrée en vigueur. Cette mesure impose aux exploitants de systèmes d'IA de signaler deux catégories de contenus : les “deepfakes” – définis comme “des contenus visuels, audio ou vidéo générés ou manipulés par l’IA qui ressemblent à des personnes, des objets, des lieux, des entités ou des événements existants et qui pourraient faussement paraître authentiques ou véridiques à une personne” – et les textes générés ou manipulés par l’IA publiés pour “informer le public sur des questions d’intérêt général, lorsqu’aucun contrôle humain ni aucune vérification éditoriale n’ont eu lieu et qu’aucune personne morale ou physique n’a assumé la responsabilité éditoriale”. La divulgation peut être assurée par des watermarks ou d’autres marqueurs permettant une détection aisée. Tout manquement à cette obligation est passible d’amendes conséquentes.
🤝 Cet article a été rédigé dans le cadre du projet collaboratif PULSE. György Folk (EUrologus/HVG, Budapest) y a largement contribué.
Vous appréciez notre travail ?
Contribuez à faire vivre un journalisme européen et multilingue, libre d’accès et sans publicité. Votre don, ponctuel ou mensuel, garantit l’indépendance de notre rédaction. Merci !


